测序技术:从一代到三代,你手上那条序列从何而来
第2章 第1讲 · 从一代到三代
第1集 · 从生物样本到 library:样本制备与测序词汇
测序的起点是生物样本,终点是数字化的 reads;中间每一步都可能改变最终数据。
Sequence 是一条加工链的终点
1 · Sample preparation
细胞裂解,分离 DNA 或 RNA。传统 RNA 流程通常先做 reverse transcription 得到 cDNA。
2 · Library preparation
按问题选择目标区域,或把 DNA 打断成 fragments,再接上平台需要的 adapters,形成 library。
3 · Sequencing
仪器读取许多 template,输出 reads;之后才是 mapping、assembly 和 inference。
样本制备位于所有信号的上游:这里的降解、污染或 amplification bias 会被后续步骤继承。
书中的常规 RNA 路线先做 reverse transcription;Oxford Nanopore 也存在 direct RNA sequencing。
六个词分别指物理对象或数字输出
template
模板:将被测序的一条 DNA/cDNA molecule 或 fragment。
primer
引物:与 template 互补并提供 polymerase 起点的短核酸。
adapter
接头:接到 insert 两端、让 molecule 能被平台捕获和读取的已知序列。
library
文库:许多不同 library molecules 的物理混合物,不是数据库。
read
读段:仪器对一个 molecule 或 clonal group 给出的数字序列输出。
sequencing run
仪器完成的一轮测量;一轮通常产生许多 reads,而不是一条。
template 是物理 molecule;read 是测量后保存的数字实现值。二者不是同一类对象。
后面每个平台都要回答三个问题
Separation(分离)
怎样让不同 templates 的信号不混在一起?
colony · droplet · bead · cluster · single molecule
Amplification(扩增)
是否需要复制 molecule,让信号强到可检测?
target amplification ≠ clonal signal amplification
Detection(检测)
真正被测量的物理量是什么?
fluorescence · light · pH · ionic current
平台名称很多,但可以用同一套 separation–amplification–detection 框架比较。
第2集 · PCR:三温度循环与 2ⁿ 扩增
PCR 增加 template 的物理拷贝数;它本身不读取 nucleotide sequence。
PCR 需要一条 template 和三类工具
template DNA
要复制的序列。
一对 primers
分别限定复制区域的两端,并提供延伸起点。
dNTPs
合成新 DNA strand 的原料。
thermostable DNA polymerase
经受反复高温后仍能延伸新链的酶。
PCR 解决的是数量,不解决“是哪一条序列”:拷贝变多了,但 sequence 仍要靠后面的 detection 来读。
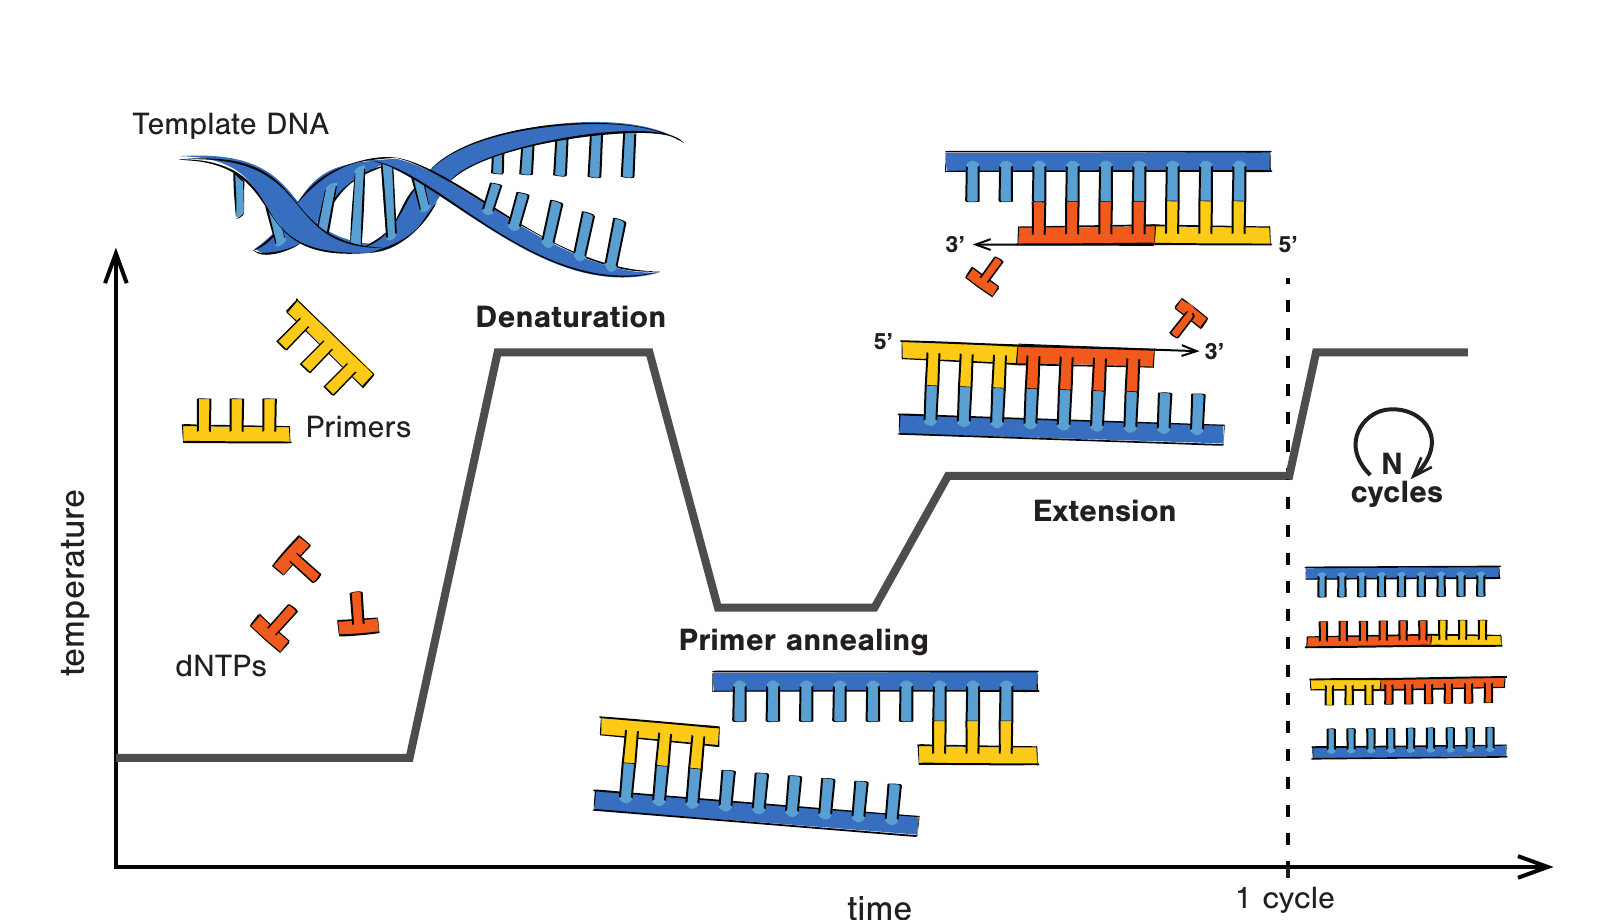
一个 cycle 依次经历三个温度阶段
Figure 2.1,printed p.30
Denaturation 分开双链,primer annealing 确定起点,extension 合成互补链;下一轮会复制上一轮刚产生的 molecules。
理想拷贝数按 2ⁿ 增长,真实效率留下 bias
理想模型
每个 cycle:所有双链 molecules 都加倍。
1 → 2 → 4 → 8 → 16 → … → 2ⁿ
真实反应
效率低于 100%,后期进入平台期;不同 GC、长度和 primer 结合能力的 templates 也可能扩增效率不同。
PCR 很快增加总 DNA,但也会改变初始 molecule 的相对数量,并可能把早期错误一并复制。
第3集 · 第一代 Sanger sequencing:chain termination 与 gel 读序
Sanger 用不同长度的 terminated fragments,把 sequence 转成可排序的 ladder。
Sanger 把三件事串成一条手工流程
Separation
Recombinant DNA 进入细菌;一个 colony 代表一个 founder template 的 clonal population。
Amplification
挑取 colony、提取 DNA,再用 PCR 提高可检测的 molecule 数量。
Detection
少量 chain-terminating ddNTP 产生不同长度 fragments,再按长度排序。
Sanger 的 error rate 很低,仍常用于验证;代价是 separation 和逐反应处理难以大规模并行。
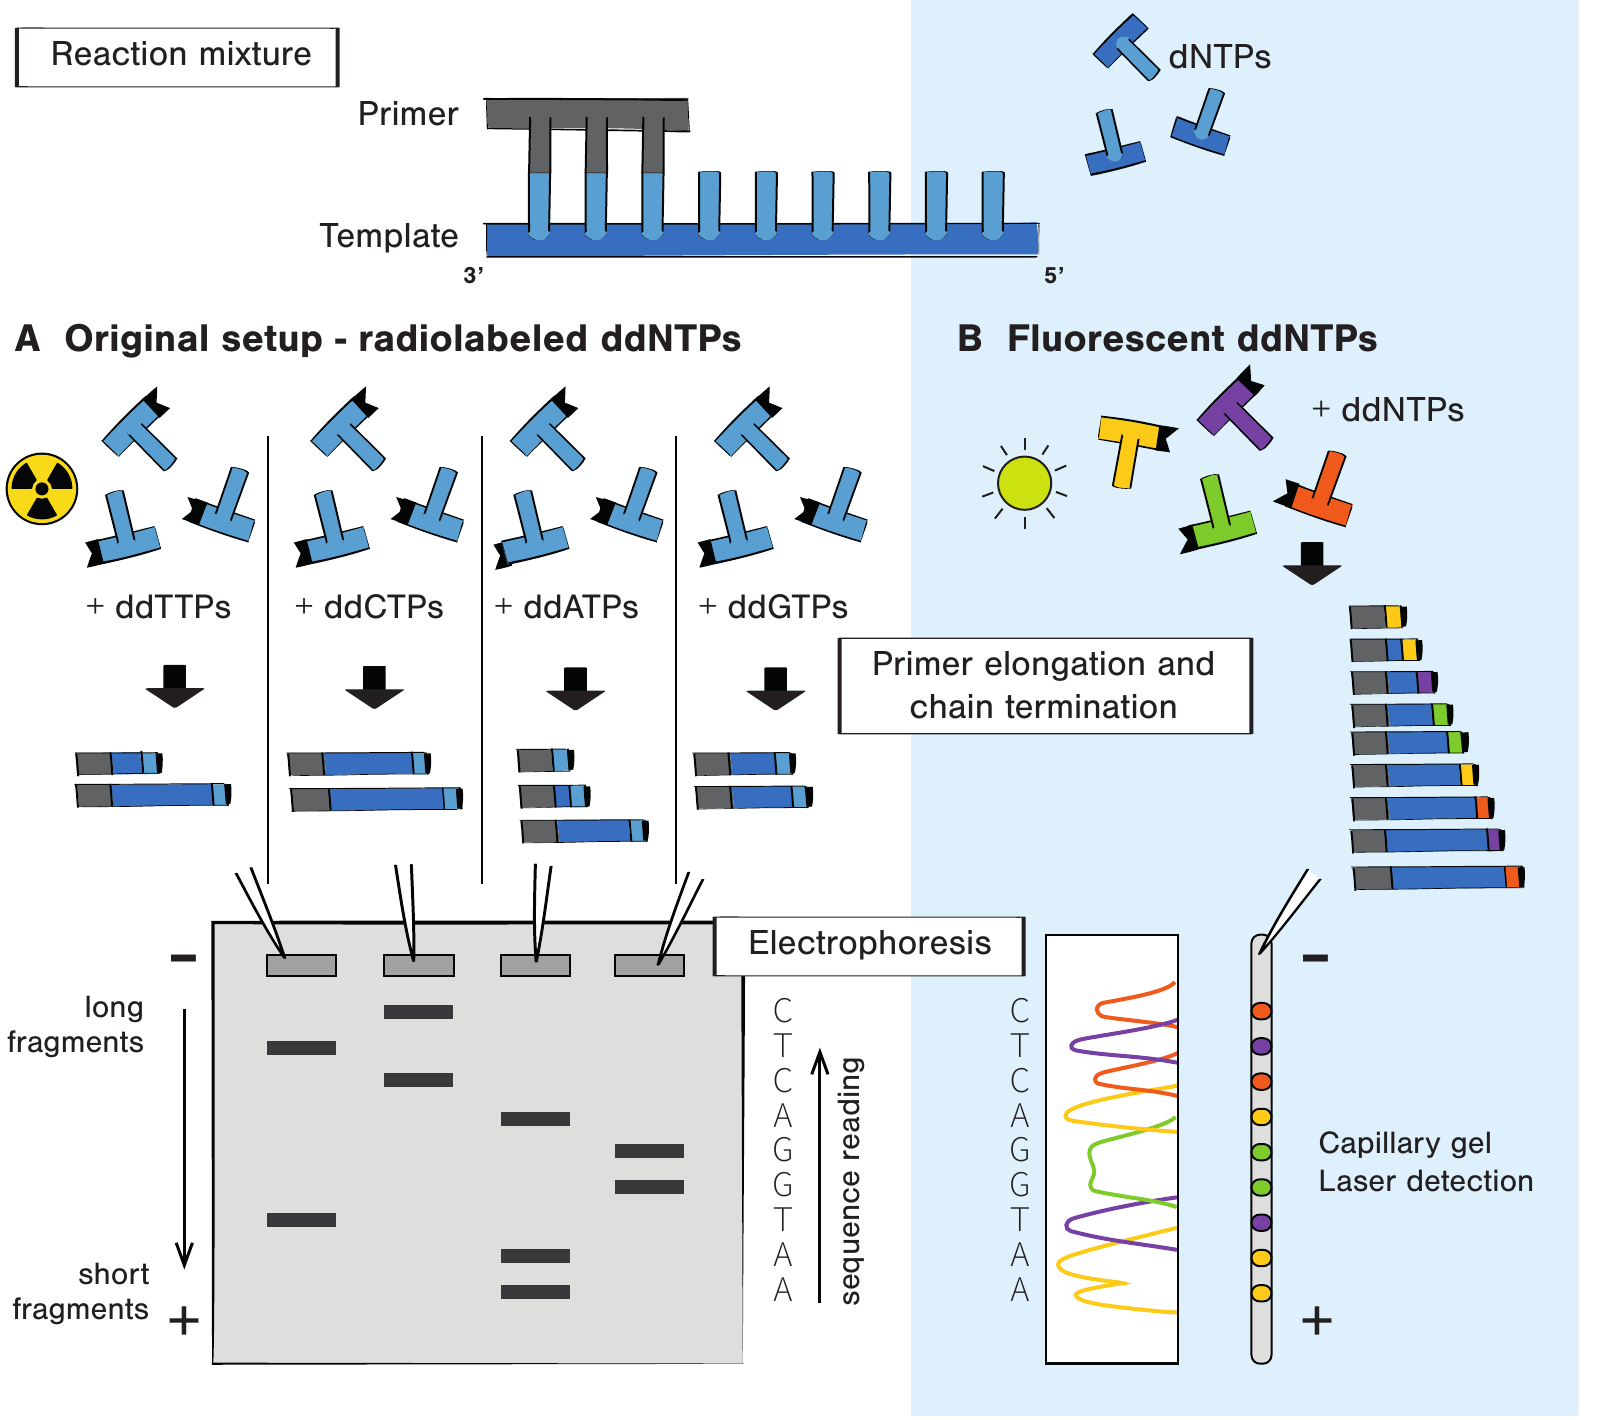
长度编码位置,末端标记编码是哪一个 base
Figure 2.2,printed p.33
ddNTP 缺少 3′-OH,一旦掺入就终止延伸;许多相同 template 在不同位置终止,才得到每种长度都有的 fragment ladder。
左半边四泳道 gel 由下(短)向上(长)读出的是新合成链;右半边单管四色 fluorescent ddNTP 用 capillary 与颜色做同一件事。若问题问的是原 template,还要写 reverse complement。
第4集 · 第二代架构:emulsion PCR 与 454 / Ion Torrent 的「灌注—检测」
第二代把 separation 从细菌里的 cloning 换成体外的 droplets,再由 454 与 Ion Torrent 按 nucleotide 类型轮流灌注、读取信号。
Barcodes 让许多 samples 共用一个 run
大规模并行
大量在空间上彼此分开的 templates 同时被读取;通量不再受逐个 colony 操作的限制。
多样本 barcoding
在混合前给每个 sample 接上独特 barcode;测完后按 barcode 把 reads 分回来源。
并行回答“同一时刻读多少 templates”;barcoding 回答“这些 reads 原来属于哪个 sample”。
Emulsion PCR 在 droplets 中同时完成分离与扩增
装入
油包水 droplets 中加入 bead、primer、template、dNTP 和 polymerase。
复制
理想情况是一滴一个 founder template;PCR 后 bead 表面覆满 clonal 拷贝。
失败模式
一滴若进入两个不同 templates,bead 上会混合两种拷贝,产生 mixed-signal 。
454、Ion Torrent 和 SOLiD 都使用这套分离与扩增机制;Illumina 改用 flow-cell bridge amplification。
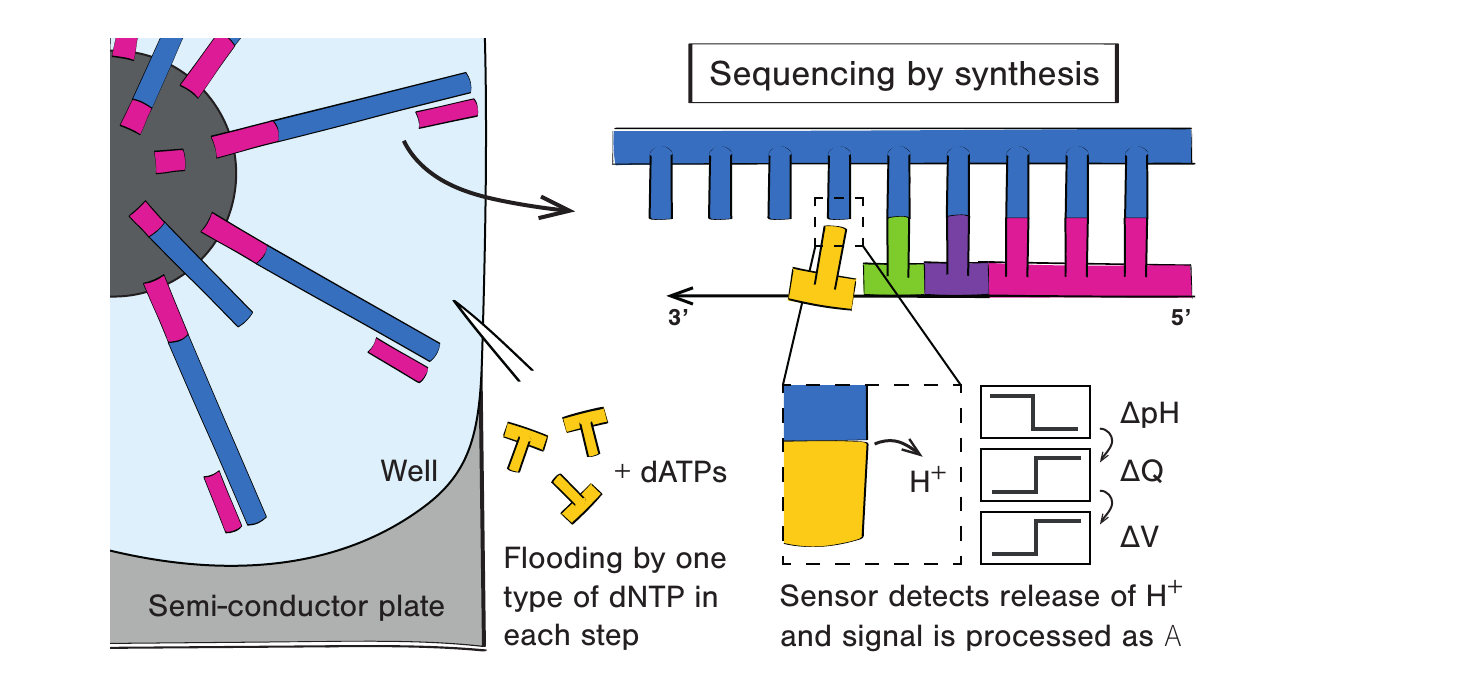
灌注—掺入—检测—冲洗:454 读光,Ion Torrent 读电信号
Figure 2.5,printed p.39
454
Nucleotide incorporation 经 pyrophosphate 相关的化学反应产生光。
Ion Torrent
Nucleotide incorporation 释放 H+;semiconductor sensor 读取与 pH 相关的电信号。
一轮只灌一种 dNTP:互补才掺入,记录信号后冲掉、再换下一种。读出的是哪一种 base,由“当前灌的是哪一种”决定;同一次灌注掺入了几颗,则要靠信号幅度推断。
四个 NGS 平台今天的状态:454 已于 2016 年停产,SOLiD 已停产,Ion Torrent 仍在售,Illumina 是最广泛使用的 NGS 技术。
Homopolymer 把“数几个”变成“估幅度”
同一次灌注
Template 出现连续 TTTTTTT 时,一次 dATP 灌注会连续加入多个 A,只形成一个较高的信号脉冲。
为什么会错
7-mer 与 8-mer 对应相邻的理想信号档位;测量噪声会让两档重叠。
只有 flood-and-detect 这一类架构会这样。 Illumina 每 cycle 只加一个 base,不靠信号幅度数 homopolymer 的长度,机制留到 Illumina 那一集。
第5集 · SOLiD:sequencing by ligation 与 two-base colour code
SOLiD 不用 polymerase sequencing-by-synthesis,而用 ligase 和 two-base colour code 读取 template。
一个 probe 的颜色由前两个 bases 共同决定
X 与 Y
与 template 配对;两者的组合决定 fluorophore 的颜色,因此一次读数报告一个 dinucleotide。
N N N
简并位点,不参与这次颜色的判定。
Z Z Z
通用尾部;读光后切除,为下一次 ligation 留出接口。
记住 XYNNNZZZ 的信息结构即可,不需要背完整 4×4 colour code。
五个 primer 起点,让每个 base 被读到两次
一个 cycle
连接匹配的 octamer → 读颜色 → 切除 ZZZ → 连接下一个 probe。
每次向前推进 5 nt,但只报告其中 2 nt。
五个起点
完成一轮后移除延伸链,将 primer 起点前移 1 nt;五个起点合起来覆盖所有位点。
Primer shifts 让一个 base 在相邻的两次 dinucleotide 读数中被读到两次,提供一次内部的 error 检查。
SOLiD 已停产,留下来的是 two-base encoding 的冗余
优势
Two-base encoding 使 substitution error 往往破坏不止一次颜色转换,便于识别不一致。
边界
流程与解码较复杂,AT 含量高的 repetitive regions 的 coverage 也可能较低。Thermo Fisher 已停产该平台,今天不会用它产数据。
本集要带走三件事:sequencing by ligation、two-base colour code、primer shifts。完整 4×4 colour code 的手工解码不在本课程范围。
第6集 · Illumina:bridge amplification 与 reversible terminator
Illumina 把 templates 铺在 flow cell 表面,原位扩增成 clusters,再逐 cycle 读取 fluorescence。
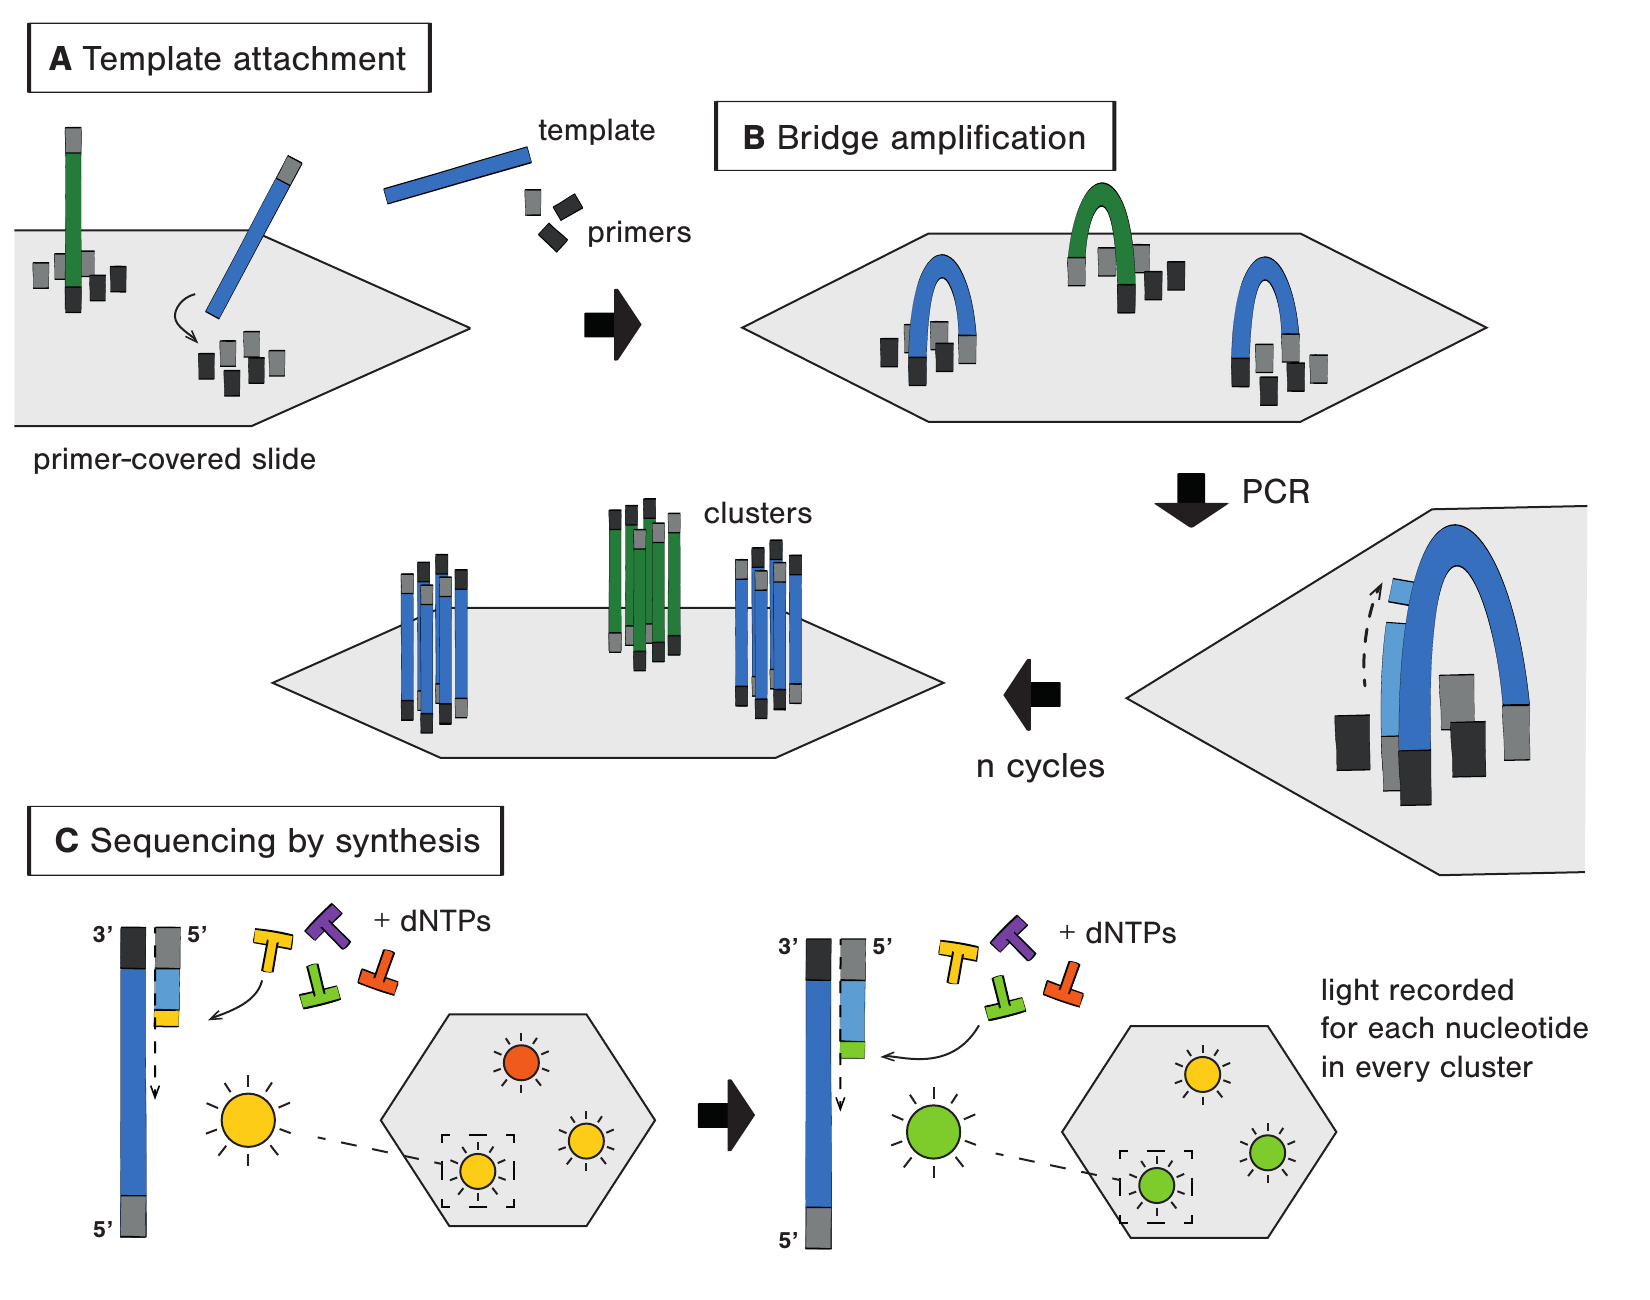
Bridge amplification 让一条附着链就地长成 cluster
① 一条附着链 ② 弓向邻近 primer ③ 从邻近 primer 3′ 端延伸 ④ 反复 → cluster 变性后两条链都保持表面附着;重复弯曲与延伸,局部拷贝逐渐增加
被洗走的是游离试剂与未保留的 strands;表面共价连接的 strands 留下,并在后续 cycles 继续充当 templates。
同样叫 amplification:ARTIC 选目标,cluster 放大信号
ARTIC tiled multiplex PCR
上机前 :多对 locus-specific primers 将 viral cDNA 做成重叠 amplicons。
任务 = target amplification ;主要 bias 来自 primer 的扩增效率、primer 之间的竞争,以及 binding site 上的 mutation。
Illumina bridge amplification
flow cell 上 :带共同 adapters 的 library molecule 就地形成 clonal cluster。
任务 = signal amplification;fragment 长度、GC、附着效率和 cluster formation efficiency 仍会改变各 molecule 的相对丰度。
Clonal 只表示一个 cluster 共享一个 founder,不表示每条 library molecule 形成 cluster 的概率相同。Coverage 会继承 RT → ARTIC PCR → library prep → cluster generation → sequencing/mapping 的 bias。
本讲补充 · Quick et al. 2017 · ARTIC protocol v4 · Aird et al. 2011
Reversible terminator 把一个 cycle 限定为一个 base
加入并成像
四种可区分、带 reversible terminator 的 dNTP 同时存在;每个 cluster 只加入当前互补的一颗并暂停。
切除并重复
记录 fluorescence 后,移除 fluorophore 与 terminator,恢复 3′ 端,再进入下一 cycle。
Illumina 用 clusters 取得高并行 short reads;常见设计是 paired-end,例如 2 × 150 bp。它适合 viral consensus、variant calling 和计数类问题,不要求一条 read 覆盖整个 genome。
本讲补充 · 依据 Illumina 官方 SBS chemistry 与 read-length 技术文档
第7集 · 第三代 single-molecule 测序,与三代之间的取舍
Single-molecule 平台取消的是 clonal signal amplification,不是所有可能的 target enrichment。
Clonal detection 与 single-molecule detection 读的对象不同
Illumina / 早期 NGS
一个 bead 或 cluster 中许多 clonal 拷贝同步反应,检测器读取合并后的信号。
PacBio / Nanopore
检测器直接跟踪单个 molecule 的 fluorescence 或 ionic current 轨迹,不需要 clonal signal amplification。
“不需要 amplification”只指 signal detection。 具体 PacBio 或 Nanopore library protocol 仍可能使用 target PCR、amplicon sequencing 或 enrichment。
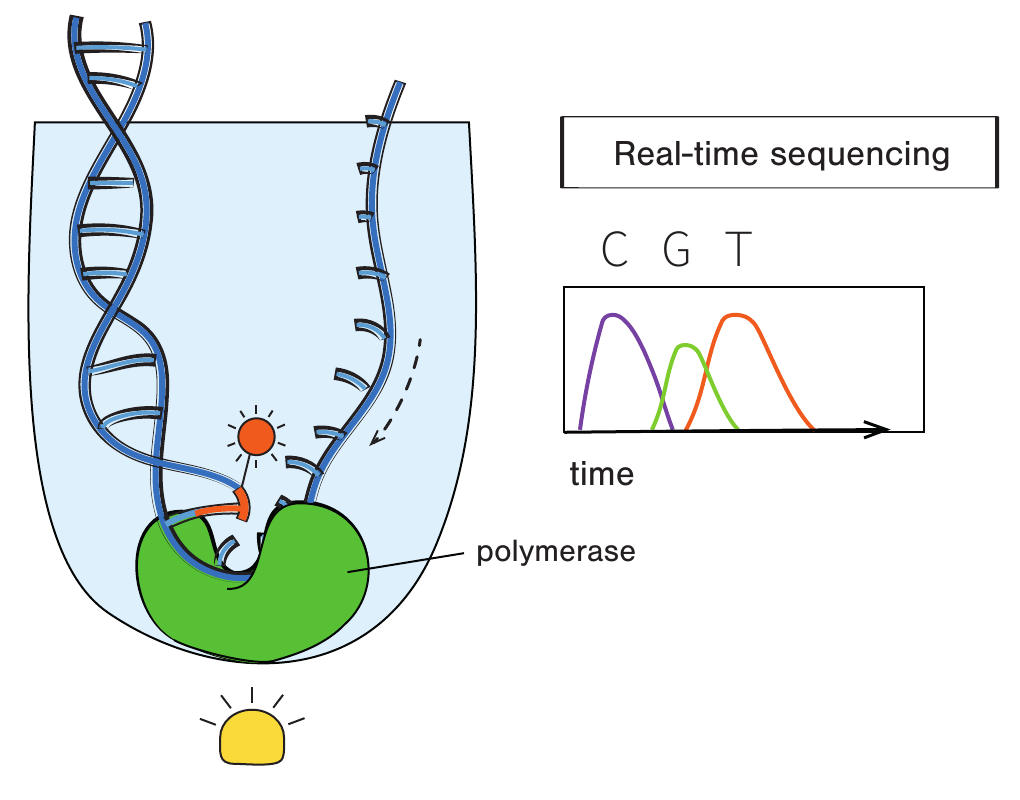
PacBio 在 ZMW 中边合成边测 fluorescence
Figure 2.7,printed p.42
PacBio 的 long read 来自 polymerase 对一条 template 的持续合成;早期 single-pass SMRT reads 的总 error 可达约 10–15%,不能代表现代 HiFi read。
CCS 把同一 insert 的多次观察合成 HiFi read
环状 template
给双链 insert 两端连接 hairpin adapters,形成 SMRTbell circular template。
多次绕圈
Polymerase 多次绕过同一 insert,得到多个 subreads;每一圈可能在不同位置出错。
Circular consensus
CCS 把 subreads 对齐并取 consensus,生成现代 PacBio HiFi read。
当前 HiFi 的典型 read 长度约 15–20 kb,官方资料报告准确率中位数高于 99.9%。insert 越长,polymerase 在同样时间里绕的圈数越少,能取 consensus 的观察次数也越少——read 长度和准确率是同一笔账的两端。
本讲补充 · 依据 PacBio 官方 SMRT sequencing 与 HiFi 技术文档
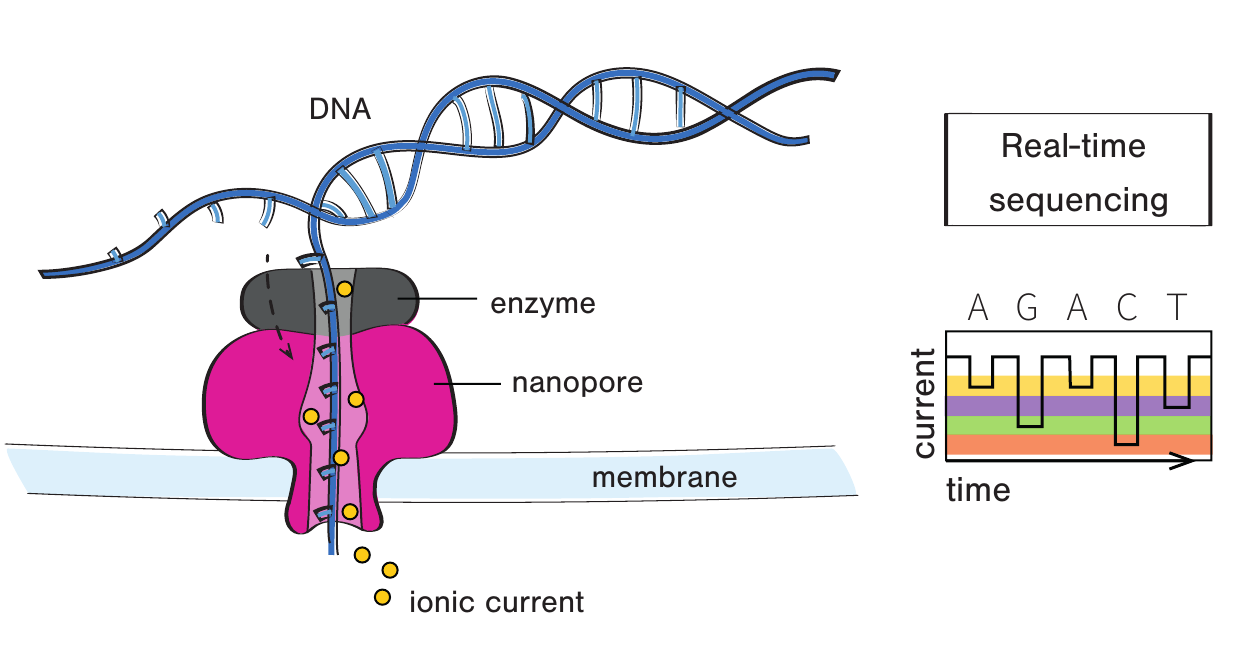
Nanopore 把一段 local sequence context 映射成 ionic current
Figure 2.8,printed p.43 · basecalling 依赖 local sequence context 是本讲补充
Ionic current 不是由一个孤立 nucleotide 单独决定:pore reader 中同时有多个 bases,一段 local sequence context(常简称 k-mer)共同塑造 squiggle,再由 neural-network basecalling 解码。
Nanopore 可读取 native DNA 或 RNA、同步识别部分 modifications,并从 short read 延伸到 ultra-long read;长度主要受送入 pore 的 molecule 完整度限制。
Table 2.1 记录的是原书成书时的代际平均水平
Speed, bp/hour
105
3 × 10¹⁰
3 × 10⁸
Typical read length
1,000
2 × 150
30,000*
Reads in parallel
96
106
105
Amplification step
yes
yes
no
Error rate
low
medium
medium-high
* 平均 fragment 长度仍在 30,000 bp 左右,但 Oxford Nanopore 已报告超过 200 万 bp 的单条 read(Amarasinghe et al. 2020)。
Table 2.1,printed p.31 · 数值是原书对每一代的 averages,不是今天每台 instrument 的 specification
第三代那一列把 PacBio HiFi 和 Oxford Nanopore 平均成了一个数。两者的 read 长度分布和错误率差很多,下一页分开看。
授权与来源 · Attribution
Adapted and translated into Chinese from: Stadler T, Magnus C, Vaughan T, Barido-Sottani J, Bošková V, Huisman JS, Pečerska J. Decoding Genomes: From Sequences to Phylodynamics (1st ed., 2024). https://decodinggenomes.org · DOI: 10.3929/ethz-b-000664449. Original licensed under CC BY-SA 4.0; this derivative work is likewise released under CC BY-SA 4.0. Changes: translated to Chinese, reorganised into video lessons and slides; Figures 2.1, 2.2, 2.5, 2.6, 2.7 and 2.8 reproduced as cropped teaching figures; Table 2.1 re-typeset and translated; course-specific comparisons and teaching diagrams added.
Source range: Chapter 2 §§2.1-2.4, printed pp. 27-44 · Reused book-owned figures: 2.1, 2.2, 2.5, 2.6, 2.7, 2.8 (CC BY-SA 4.0)